Guided Online Distillation: Promoting Safe Reinforcement Learning by Offline Demonstration
Jan 15, 2024· ,,,,,,·
1 min read
Xinyi Liu
Jinning Li
Banghua Zhu
Jiantao Jiao
Masayoshi Tomizuka
Chen Tang
Wei Zhan
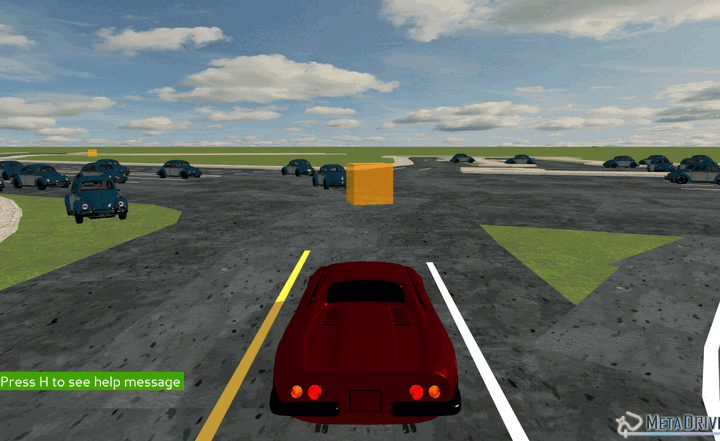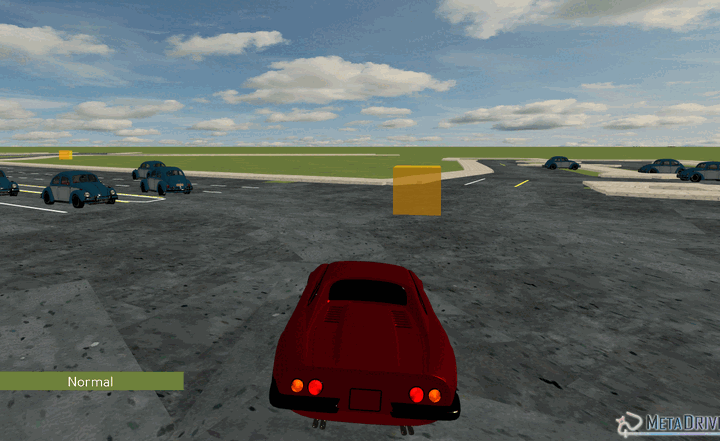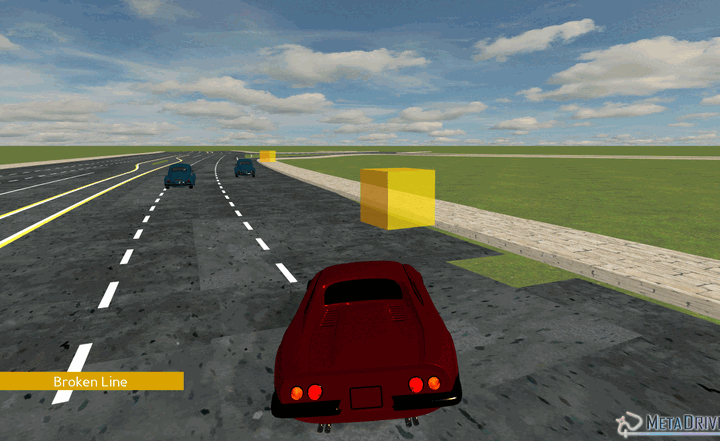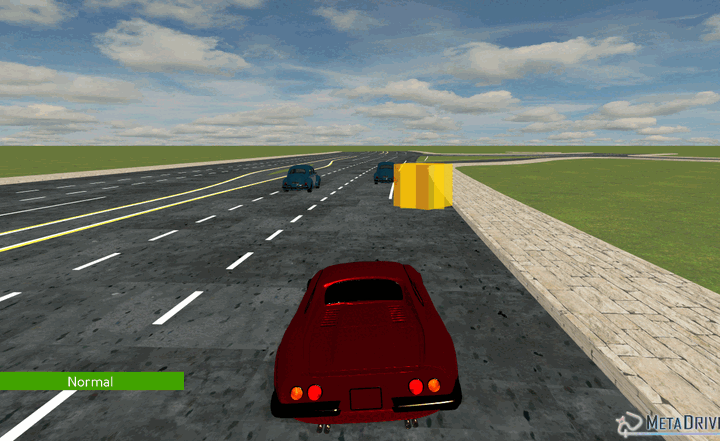 GOLD Framework for Safe RL
Abstract
Safe Reinforcement Learning (RL) aims to find policies that achieve high rewards while satisfying cost constraints. Existing approaches often struggle with overly conservative exploration, particularly in safety-critical domains like autonomous driving. We propose Guided Online Distillation (GOLD), an innovative offline-to-online safe RL framework that distills large-capacity offline policies into lightweight, computationally efficient policy networks through guided online safe RL training.
Type
Publication
In 2024 IEEE International Conference on Robotics and Automation (ICRA)
Mathematical Formulation
Policy Distillation Objective
The core optimization problem is formulated as:
$$ \min_{\pi_{\theta}} \mathbb{E}_{s \sim d_{\text{expert}}} \left[ L_{\text{distill}}(\pi_{\theta}(s), \pi_{\text{expert}}(s)) + \lambda L_{\text{safety}}(\pi_{\theta}) \right] $$Where:
- $\pi_{\theta}$: Online policy network
- $\pi_{\text{expert}}$: Offline expert policy
- $L_{\text{distill}}$: Policy distillation loss
- $L_{\text{safety}}$: Safety constraint loss
- $\lambda$: Regularization coefficient
Safe Exploration Constraint
The safety constraint is defined as:
$$ P(\text{safe trajectory}) \geq 1 - \epsilon $$Technical Approach
Key Components
- Two-stage policy extraction
- Offline expert policy distillation
- Online fine-tuning with safety constraints
Performance Metrics
- Reduced collision rate from 30% to <3%
- 15% improvement in driving task success rates
Research Significance
Addresses critical reinforcement learning challenges:
- Mitigates conservative exploration
- Enables lightweight policy networks
- Improves safety in autonomous systems
Implementation Highlights
- Developed versatile driving simulation platform
- Implemented online distillation procedure
- Extracted lightweight policies from transformer models
Developed at UC Berkeley’s MSC Lab under Prof. Masayoshi Tomizuka